ポート数
の制約
ポート数
の制約
に対する
出力レコード数
(0~∞レコード)
Asakusa FrameworkのOperator DSLのグループ整列演算子(@GroupSort)のメモ。
|
グループ整列演算子は、集計キーでグルーピング、ソートキーでソートし、キーが一致するデータ毎に処理して複数種類(複数データモデル)・複数レコードの出力を行う。
性能特性はCoGroup(旧ドキュメントではReduce)。[/2016-02-11]
| 入力 ポート数 |
入力データモデル の制約 |
イメージ | 出力 ポート数 |
出力データモデル の制約 |
入力1レコード に対する 出力レコード数 |
|---|---|---|---|---|---|
| 1 |
|
任意 | 任意。 (0~∞レコード) |
グループ整列演算子はグルーピングした複数レコードにまたがって処理をしたい場合に使う。
(更新演算子(@Update)や変換演算子(@Convert)は1レコード内のデータしか処理できない)
例えば、ソートした先頭n件を出力したいとか、1時間1レコードで24レコードにしたいが24時間の中にレコードが存在しない時間帯を見つけて空レコードを作るとか。
(24レコードだとAsakusaFW(Hadoop)で扱うには少なすぎて、Hadoop税が相対的に大きくなる(MapReduceジョブの起動時間の方が長くなる)可能性が高いが^^;)
複数レコードを集計したい場合は、単純集計演算子(@Summarize)や畳み込み演算子(@Fold)を使う。
グループ整列演算子はグループ結合演算子(@CoGroup)の入力ポートが1つしかないバージョン。
したがって、乱用しないように、という注意点はグループ結合演算子(@CoGroup)と同じ。
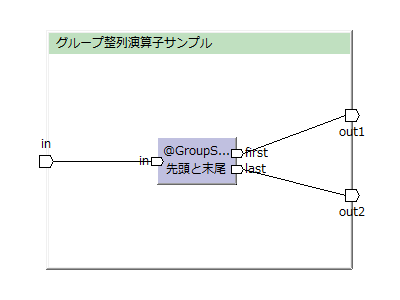
hogeをIDでグループ化し、ageが一番小さいレコードと大きいレコードを1レコードずつ出力する例。
すなわち、ageでソートして、先頭と末尾のレコードを1つずつ出力する。
(この図はToad Editorを用いて作っています)
| 入力データ例 | 出力データ例 | |||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| in |
|
→ | first |
|
||||||||||||||||||||||||
| → | last |
|
||||||||||||||||||||||||||
hoge = {

    id : TEXT;

    age : INT;
};
import java.util.List;

import com.asakusafw.runtime.core.Result;
import com.asakusafw.vocabulary.model.Key;
import com.asakusafw.vocabulary.operator.GroupSort;

import com.example.modelgen.dmdl.model.Hoge;
public abstract class ExampleOperator {

	/**
	 * 先頭と末尾のレコードを出力する
	 *
	 * @param in    グループ毎のリスト
	 * @param first グループ内の先頭要素
	 * @param last  グループ内の末尾要素
	 */
	@GroupSort
	public void firstLast(
		@Key(group = "id", order = "age ASC") List<Hoge> in,
		Result<Hoge> first,
		Result<Hoge> last
	) {
		if (in.size() == 1) { // [2017-12-10]
			Hoge hoge = in.get(0);
			Hoge temp = new Hoge();
			temp.copyFrom(hoge);
			first.add(hoge);
			last.add(temp);
		} else {
			first.add(in.get(0));
			last.add(in.get(in.size() - 1));
		}
	}
}
第1引数で、入力ポートを表すList<データモデル>を指定する。
この引数には@Keyアノテーションを付けて、集計キー(グループ化するキー)を指定する。
複数の項目を集計キーとする場合は「@Key(group = { "key1", "key2" })」のように波括弧でくくってカンマ区切りで指定する。
また、@Keyアノテーションのorderでソートキーを指定できる。
このListには必ず1件以上データが入ってくる。(たぶん自明なので、ドキュメントには明記されていない)[2017-02-11]
第2引数以降に、出力ポートを表すResult<データモデル>を指定する。
Resultにaddする場合、一度addしたオブジェクトは使用することは出来ない(内容が破壊される可能性がある)。[2017-12-10]
そのため、2回addしたい場合はオブジェクトをコピーして取っておく必要がある。
import com.example.modelgen.dmdl.model.Foo;
import com.example.modelgen.dmdl.model.Hoge;

import com.example.operator.ExampleOperatorFactory;
import com.example.operator.ExampleOperatorFactory.FirstLast;
	private final In<Hoge> in;

	private final Out<Hoge> out1;
	private final Out<Hoge> out2;
	@Override
	public void describe() {
		ExampleOperatorFactory operators = new ExampleOperatorFactory();

		// 先頭と末尾のレコードを出力する
		FirstLast fl = operators.firstLast(this.in);

		this.out1.add(fl.first);
		this.out2.add(fl.last);
	}
Flow DSLでは、自分が作ったOperatorのFactoryクラス(AsakusaFWのコンパイラーによって生成される)を使用する。
メソッド名はOperatorクラスに書いたメソッド名と同じ。
戻り値の型はAsakusaFWのコンパイラーによって生成されたクラス。(メソッド名を先頭が大文字のキャメルケースに変換したもの)
メソッドの引数はOperatorクラスのメソッドに入力ポート(List<データモデル>)として指定したデータ。
出力ポートの名前は、Operatorクラスのメソッドに出力ポート(Result<データモデル>)として指定した変数名が使われる。
グループ整列演算子の単体テストの実装例。
package com.example.operator;
import static org.hamcrest.CoreMatchers.is;
import static org.junit.Assert.assertThat;

import java.util.ArrayList;
import java.util.List;

import org.junit.Test;

import com.asakusafw.runtime.testing.MockResult;
import com.example.modelgen.dmdl.model.Hoge;
/**
 * {@link ExampleOperator}のテスト.
 */
public class ExampleOperatorTest {

	@Test
	public void firstLast() {
		ExampleOperator operator = new ExampleOperatorImpl();

		List<Hoge> in = new ArrayList<Hoge>();
		for (int i =0; i < 3; i++) {
			Hoge hoge = new Hoge();
			hoge.setAge(20 + i);
			in.add(hoge);
		}

		MockResult<Hoge> first = new HogeMockResult();
		MockResult<Hoge> last = new HogeMockResult();

		operator.firstLast(in, first, last);

		{
			assertThat(first.getResults().size(), is(1));
			assertThat(first.getResults().get(0).getAge(), is(20));
		}
		{
			assertThat(last.getResults().size(), is(1));
			assertThat(last.getResults().get(0).getAge(), is(22));
		}
	}
}
Operatorのテストクラスは、通常のJavaのJUnitのテストケースクラスとして作成する。
テスト対象のOperatorクラス自身は抽象クラスだが、Operatorクラス名の末尾に「Impl」の付いた具象クラスがAsakusaFWによって生成されるので、それを使う。
グループ結合演算子では引数にResultが使われているので、その引数にはMockResultを渡す。
OperatorメソッドでResultに追加したデータモデルは、MockResult内のリストに追加されていく。MockResult#getResults()でそのリストを取得できる。
ただし、Operatorクラス側でデータモデルのインスタンスを使い回している場合は、MockResultのリストにそのインスタンスを追加するだけだと、後から値を確認したくても最後の値しか取れない。
そこで、MockResult#bless()をオーバーライドし、インスタンスのコピーを返すようにする。こうすると、MockResultのリストにはコピーしたインスタンスが保持される。
public class HogeMockResult extends MockResult<Hoge> {

	@Override
	protected Hoge bless(Hoge result) {
		Hoge copy = new Hoge();
		copy.copyFrom(result);
		return copy;
	}
}
グループ整列演算子では、入出力のデータモデルの他にも引数を指定することが出来る。
こうすると、引数の内容分だけ異なる同じ演算子(処理内容)をいくつかの場所で使用できるようになる。
先の例に値引数を追加し、先頭n件・末尾n件を出力する例。
	@GroupSort
	public void firstLast(
		@Key(group = "id", order = "age ASC") List<Hoge> in,
		Result<Hoge> first,
		Result<Hoge> last,
		int size
	) {
		int end = Math.min(size, in.size());
		for (int i = 0; i < end; i++) {
			first.add(in.get(i));
		}

		int start = Math.max(0, in.size() - size);
		for (int i = start; i < in.size(); i++) {
			last.add(in.get(i));
		}
	}
出力ポートを示す引数以降を通常のJavaメソッドと同様に自由な引数とすることが出来る。(ただしプリミティブのみ)
	@Override
	public void describe() {
		ExampleOperatorFactory operators = new ExampleOperatorFactory();

		// 先頭と末尾から10レコードを出力する
		FirstLast fl = operators.firstLast(this.in, 10);
~
	}
演算子を使用するFlow DSLで、引数に具体的な値を指定する。
グループ整列演算子を使って、抜けているレコードを補填する例。[2013-11-30]
key2が0~9の10レコードになるように出力する。
| 入力データ例 | 出力データ例 | ||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| in |
|
→ | out |
|
|||||||||||||||||||||||||||||||||||||||||||||
hoge_fill = {

    key1 : TEXT;

    key2 : INT;

    value : INT;
};
import java.util.List;

import com.asakusafw.runtime.core.Result;
import com.asakusafw.vocabulary.model.Key;
import com.asakusafw.vocabulary.operator.GroupSort;

import com.example.modelgen.dmdl.model.HogeFill;
	/** 穴埋め用レコード */
	private final HogeFill hogeFill = new HogeFill();
	/**
	 * レコード埋め
	 *
	 * @param in  入力
	 * @param out 出力
	 */
	@GroupSort
	public void fill(@Key(group = "key1") List<HogeFill> in, Result<HogeFill> out) {
		boolean[] exists = new boolean[10];

		HogeFill first = null;

		for (HogeFill record : in) {
			exists[record.getKey2()] = true;

			// 存在するレコードの出力
			out.add(record);

			// 先頭レコードを保持
			if (first == null) {
				first = record;
			}
		}

		// 穴埋めレコードの出力
		for (int i = 0; i < exists.length; i++) {
			if (!exists[i]) {
				hogeFill.reset();
				hogeFill.setKey1Option(first.getKey1Option());
				hogeFill.setKey2(i);
				hogeFill.setValue(0);

				out.add(hogeFill);
			}
		}
	}
GroupSortのメソッドが呼ばれている以上、入力データのListは必ず1レコード以上存在する。
したがって、上記のfirstは必ず初期化される。
Result(上記のout)に出力(add)すると、そのデータモデル(上記のhogeFill)の内容は破壊される(可能性がある)ので、使うときに毎回初期化する必要がある。[2017-04-25]
import static org.hamcrest.CoreMatchers.is;
import static org.junit.Assert.assertThat;

import java.util.ArrayList;
import java.util.List;

import org.junit.Test;

import com.asakusafw.runtime.testing.MockResult;
import com.example.modelgen.dmdl.model.HogeFill;
public class ExampleOperatorTest {

	@Test
	public void fill() {
		ExampleOperator operator = new ExampleOperatorImpl();

		List<HogeFill> in = new ArrayList<HogeFill>(3);
		in.add(create(4, 123));
		in.add(create(5, 456));
		in.add(create(8, 789));

		MockResult<HogeFill> out = new MockResult<HogeFill>() {
			@Override
			protected HogeFill bless(HogeFill result) {
				HogeFill copy = new HogeFill();
				copy.copyFrom(result);
				return copy;
			}
		};

		operator.fill(in, out);

		List<HogeFill> expected = new ArrayList<HogeFill>(10);
		expected.add(create(4, 123));
		expected.add(create(5, 456));
		expected.add(create(8, 789));
		expected.add(create(0, 0));
		expected.add(create(1, 0));
		expected.add(create(2, 0));
		expected.add(create(3, 0));
		expected.add(create(6, 0));
		expected.add(create(7, 0));
		expected.add(create(9, 0));
		assertThat(out.getResults(), is(expected));
	}
	private HogeFill create(int key2, int value) {
		HogeFill record = new HogeFill();
		record.setKey1AsString("aaa");
		record.setKey2(key2);
		record.setValue(value);
		return record;
	}
}
グループ整列演算子を使って、いわゆる縦持ちデータを横持ちに変換する例。[2013-11-30]
(→横持ちを縦持ちに変換する例)
| 入力データ例 | 出力データ例 | |||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| in |
|
→ | out |
|
||||||||||||||||||||||||
hoge_v = {

    key : TEXT;

    value : INT;
};

hoge_h = {

    key : TEXT;

    value0 : INT;

    value1 : INT;

    value2 : INT;
};
import java.util.List;

import com.asakusafw.runtime.core.Result;
import com.asakusafw.vocabulary.model.Key;
import com.asakusafw.vocabulary.operator.GroupSort;

import com.example.modelgen.dmdl.model.HogeH;
import com.example.modelgen.dmdl.model.HogeV;
	/**
	 * 縦持ちデータを横持ちに変換
	 *
	 * @param in  入力
	 * @param out 出力
	 */
	@GroupSort
	public void convert(@Key(group = "key") List<HogeV> in, Result<HogeH> out) {
		HogeH hogeH = new HogeH();

		HogeV hogeV = in.get(0);
		hogeH.setKey(hogeV.getKey());
		hogeH.setValue0(hogeV.getValue());

		if (in.size() > 1) {
			hogeV = in.get(1);
			hogeH.setValue1(hogeV.getValue());
		}
		if (in.size() > 2) {
			hogeV = in.get(2);
			hogeH.setValue2(hogeV.getValue());
		}

		out.add(hogeH);
	}
値をセットしない場合は、nullがセットされたのと同じ扱いになる。
使う側は、末尾に「Option」の付いたgetterメソッドを使って「hogeH.getValue2Option().isNull()」の様にしてnullかどうかをチェックすることが出来る。
import static org.hamcrest.CoreMatchers.is;
import static org.junit.Assert.assertThat;

import java.util.ArrayList;
import java.util.List;

import org.junit.Test;

import com.asakusafw.runtime.testing.MockResult;

import com.example.modelgen.dmdl.model.HogeH;
import com.example.modelgen.dmdl.model.HogeV;
public class ExampleOperatorTest {

	@Test
	public void convert3() {
		List<HogeV> in = new ArrayList<HogeV>();
		in.add(create("aaa", 123));
		in.add(create("aaa", 456));
		in.add(create("aaa", 789));

		HogeH expected = new HogeH();
		expected.setKeyAsString("aaa");
		expected.setValue0(123);
		expected.setValue1(456);
		expected.setValue2(789);

		test(in, expected);
	}
	@Test
	public void convert2() {
		List<HogeV> in = new ArrayList<HogeV>();
		in.add(create("bbb", 1));
		in.add(create("bbb", 2));

		HogeH expected = new HogeH();
		expected.setKeyAsString("bbb");
		expected.setValue0(1);
		expected.setValue1(2);

		test(in, expected);
	}
	private HogeV create(String key, int value) {
		HogeV record = new HogeV();
		record.setKeyAsString(key);
		record.setValue(value);
		return record;
	}
	private void test(List<HogeV> in, HogeH expected) {
		GroupSortHorizontalOperator operator = new GroupSortHorizontalOperatorImpl();

		MockResult<HogeH> out = new MockResult<HogeH>();

		operator.convert(in, out);

		assertThat(out.getResults().size(), is(1));
		assertThat(out.getResults().get(0), is(expected));
	}
}
この例ではキー1つにつき1レコードしか出力されないので、MockResultの中で複製を作る(bless()をオーバーライドする)必要は無い。
グループ整列演算子のOperatorクラスのメソッドで入力データを表すList<データモデル>は、
デフォルトでは少量のデータ、つまりメモリー内に乗り切るデータ量が想定されている。
その為、1つのグループに大量のデータが来るとOutOfMemoryErrorになってしまう。
1つのグループで大量のデータを扱いたい場合は、@GroupSortアノテーションでInputBuffer.ESCAPEを指定する。
(デフォルトではInputBuffer.EXPANDが指定されている)
ただし、ESCAPEを指定すると、入力のListの使い方に制限がかかる。
グループ内の先頭と末尾のレコードの平均を出力する例。
import java.util.List;

import com.asakusafw.vocabulary.flow.processor.InputBuffer;
import com.asakusafw.vocabulary.model.Key;
import com.asakusafw.vocabulary.operator.GroupSort;
	@GroupSort(inputBuffer = InputBuffer.ESCAPE)
	public void averageFirstLast(
		@Key(group = "id", order = "age ASC") List<Hoge> in,
		Result<Hoge> out
	) {
		int firstAge = in.get(0).getAge();	//先頭の値を保持

		Hoge lastHoge = in.get(in.size() - 1);
		int lastAge = lastHoge.getAge();

		Hoge hoge = new Hoge();
		hoge.setId(lastHoge.getId());
		hoge.setAge((firstAge + lastAge) / 2);

		out.add(hoge);
	}
グループ整列演算子では、入力データをソートすることが出来る。
ソートキーは、集計キーとは別に指定できる。
	@GroupSort
	public void firstLast(
		@Key(group = "id", order = "age ASC") List<Hoge> in,
		~
	) {
		~
	}
@Keyアノテーションのorderにソートキーを指定する。
| 例 | 説明 |
|---|---|
order = "key" |
ソート項目を1つ指定する例。 ソート順は昇順となる。 |
order = "key ASC" order = "key DESC" |
ASCを指定すると昇順になる。 DESCを指定すると降順になる。 |
order = { "key1 ASC", "key2 ASC" }
|
複数のソート項目を指定する例。 |
このソートは、あくまでもグループ整列演算子の入力データに対するソート。
グループ整列演算子から出力したデータは、必ずしも出力した順序になるとは限らない。
最終的な出力ファイルをソートしたい場合は、Direct I/OだとExporterクラスでソートキーを指定する。
AsakusaFW 0.9.1で、入力データを(Listでなく)Iterableで受け取ることが出来るようになった。[2017-04-30]
(ただし、実行基盤がHadoop(MapReduce)のバッチでは使えないらしい?[2017-05-01])
import com.asakusafw.runtime.core.Result;
import com.asakusafw.vocabulary.model.Key;
import com.asakusafw.vocabulary.operator.GroupSort;

import com.example.modelgen.dmdl.model.Hoge;
public abstract class ExampleOperator {

	/**
	 * 最小年齢を取得する
	 *
	 * @param ins グループ毎の一覧
	 * @param out グループ内の先頭要素
	 */
	@GroupSort
	public void getMinAge(
		@Key(group = "id", order = "age ASC") Iterable<Hoge> ins,
		Result<Hoge> out
	) {
		for (Hoge in : ins) {
			out.add(in);
			break;
		}
	}
}
メソッドの引数のListをIterableに変えるだけ。
AsakusaFW 0.9.1以降では、インスタンスを一回ずつしか使用しない場合は、@Onceを付けて明示できる。[2017-04-30]
(AsakusaFW 0.10.0で正式機能となった。[2017-12-11])
これは、先頭レコードしか使わないような場合、あるいはレコード毎に順次処理だけ行うような場合に有用。
通常のListの場合、同一キーの全データをメモリー上に展開する。
(そのため、データ量が多い場合はOutOfMemoryErrorが発生することがあり、その回避策としてInputBuffer.ESCAPEがあった)
@Onceにすると、データモデル1つのインスタンスが使い回されるようになる(インスタンス1つ分のメモリーしか使用しない)、と思う。(したがって、前のレコードのインスタンス(の参照)をそのまま保持して使うことは出来ない)
全データの(先頭の)一部しか使わないと分かっている場合は、この方がメモリー使用効率が良い。
import com.asakusafw.vocabulary.model.Once;
	@GroupSort
	public void onceExample(
		@Key(group = "id", order = "age ASC") @Once Iterable<Hoge> ins,
		Result<Hoge> out
	) {
		for (Hoge in : ins) {
			out.add(in);
		}
	}
※@OnceはIterableにしか付けられない。(Listには付けられない)
AsakusaFW 0.9.1以降では、入力データ(ListやIterable)に@Spillを付けることが出来る。[2017-04-30]
(AsakusaFW 0.10.0で正式機能となった。[2017-12-11])
CoGroupの@Spillの例を参照。(@Spillの使い方はCoGroupと同じ)